
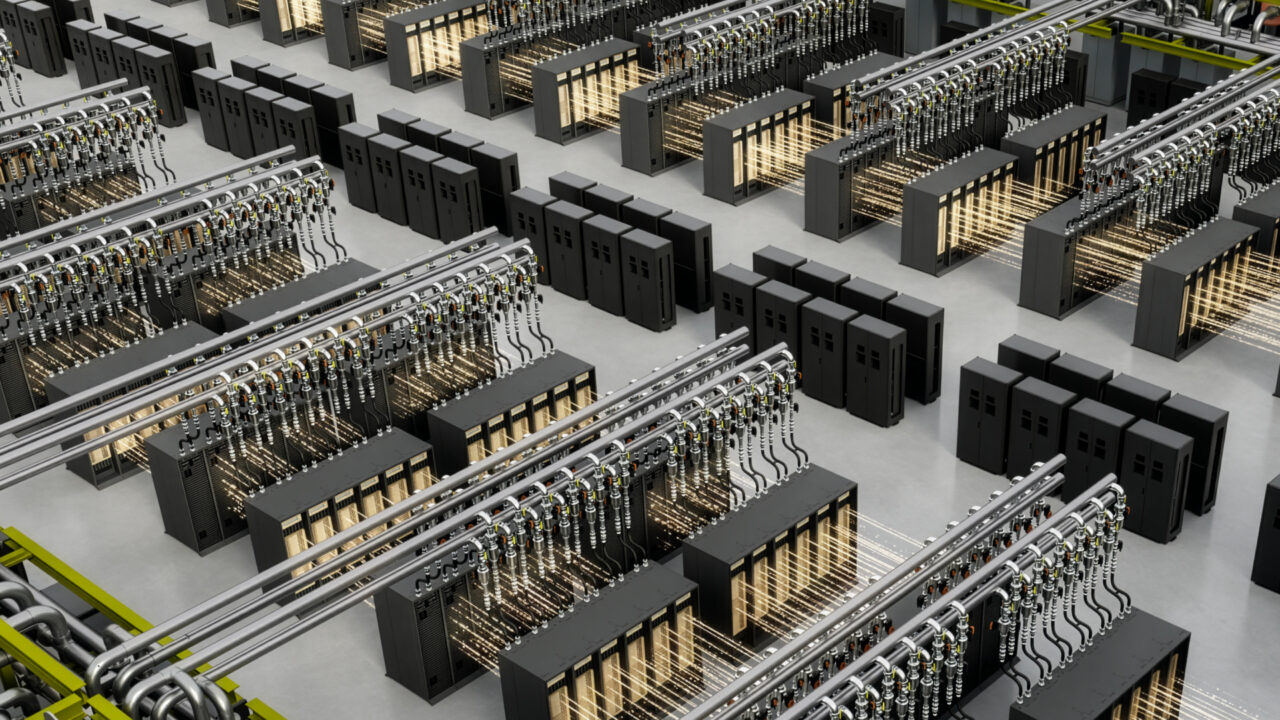
随着 AI 工厂的规模从兆瓦级增长到十亿瓦级,建造这些工厂需要的不仅仅是先进的计算。开放标准正在帮助行业以更快、更高效、更可靠的方式扩展 AI 基础设施。
在圣何塞 McEnery 会议中心举行的开放计算项目 (OCP) 全球峰会上,NVIDIA 宣布了新的合作伙伴关系和技术贡献,旨在为新一代 AI 基础设施构建通用基础。
NVIDIA 通过开放的 NVIDIA MGX 架构,向 OCP 提供了关键的 NVIDIA Vera Rubin 机架和计算托盘设计,为系统构建者开发下一代 AI 工厂基础设施提供了通用基础。
这些举措涵盖了 AI 工厂本身、为其供电的公用电网以及作为现代加速计算核心的机架级架构。
NVIDIA 与合作伙伴宣布开放架构的最新进展
在 OCP 峰会上,NVIDIA 及其合作伙伴带来多项发布:
- NVIDIA 和超大规模企业发布了新一代 AI 工厂的开放标准,包括 AI 工厂设计标准和电网可靠性。
- NVIDIA 面向 NVIDIA DSX AI Factory 推出全新开源软件组件。
- Meta 和 NVIDIA 借助 NVIDIA Spectrum-X 以太网 SuperNIC 和 Spectrum-6 创新技术,推进了开放 AI 网络的发展。
- Visionbay 推出了面向 Vera Rubin 时代的 800 VDC AI 工厂设计方案。
- NVIDIA 和思科宣布超密集小型可插拔模块 (USFP) 标准,这是业界首个用于单通道 400Gb/s 网络的模块。
- NVIDIA 和谷歌宣布未来 NVIDIA ConnectX-10 SuperNIC 和 BlueField DPU 将支持 Falcon Transport。
在座无虚席的会场中,NVIDIA 超大规模与高性能计算副总裁 Ian Buck 讨论了开放基础设施如何成为推动全球 AI 工厂规模化扩展的关键要素。
OCP 峰会上的系列新闻重点介绍了 NVIDIA 的极致协同设计正与开放标准相结合,如何加速部署、提高能效并提高每瓦 Token 性能。
OCP 峰会:MGX 机架助力 Vera Rubin AI 工厂加速推进 
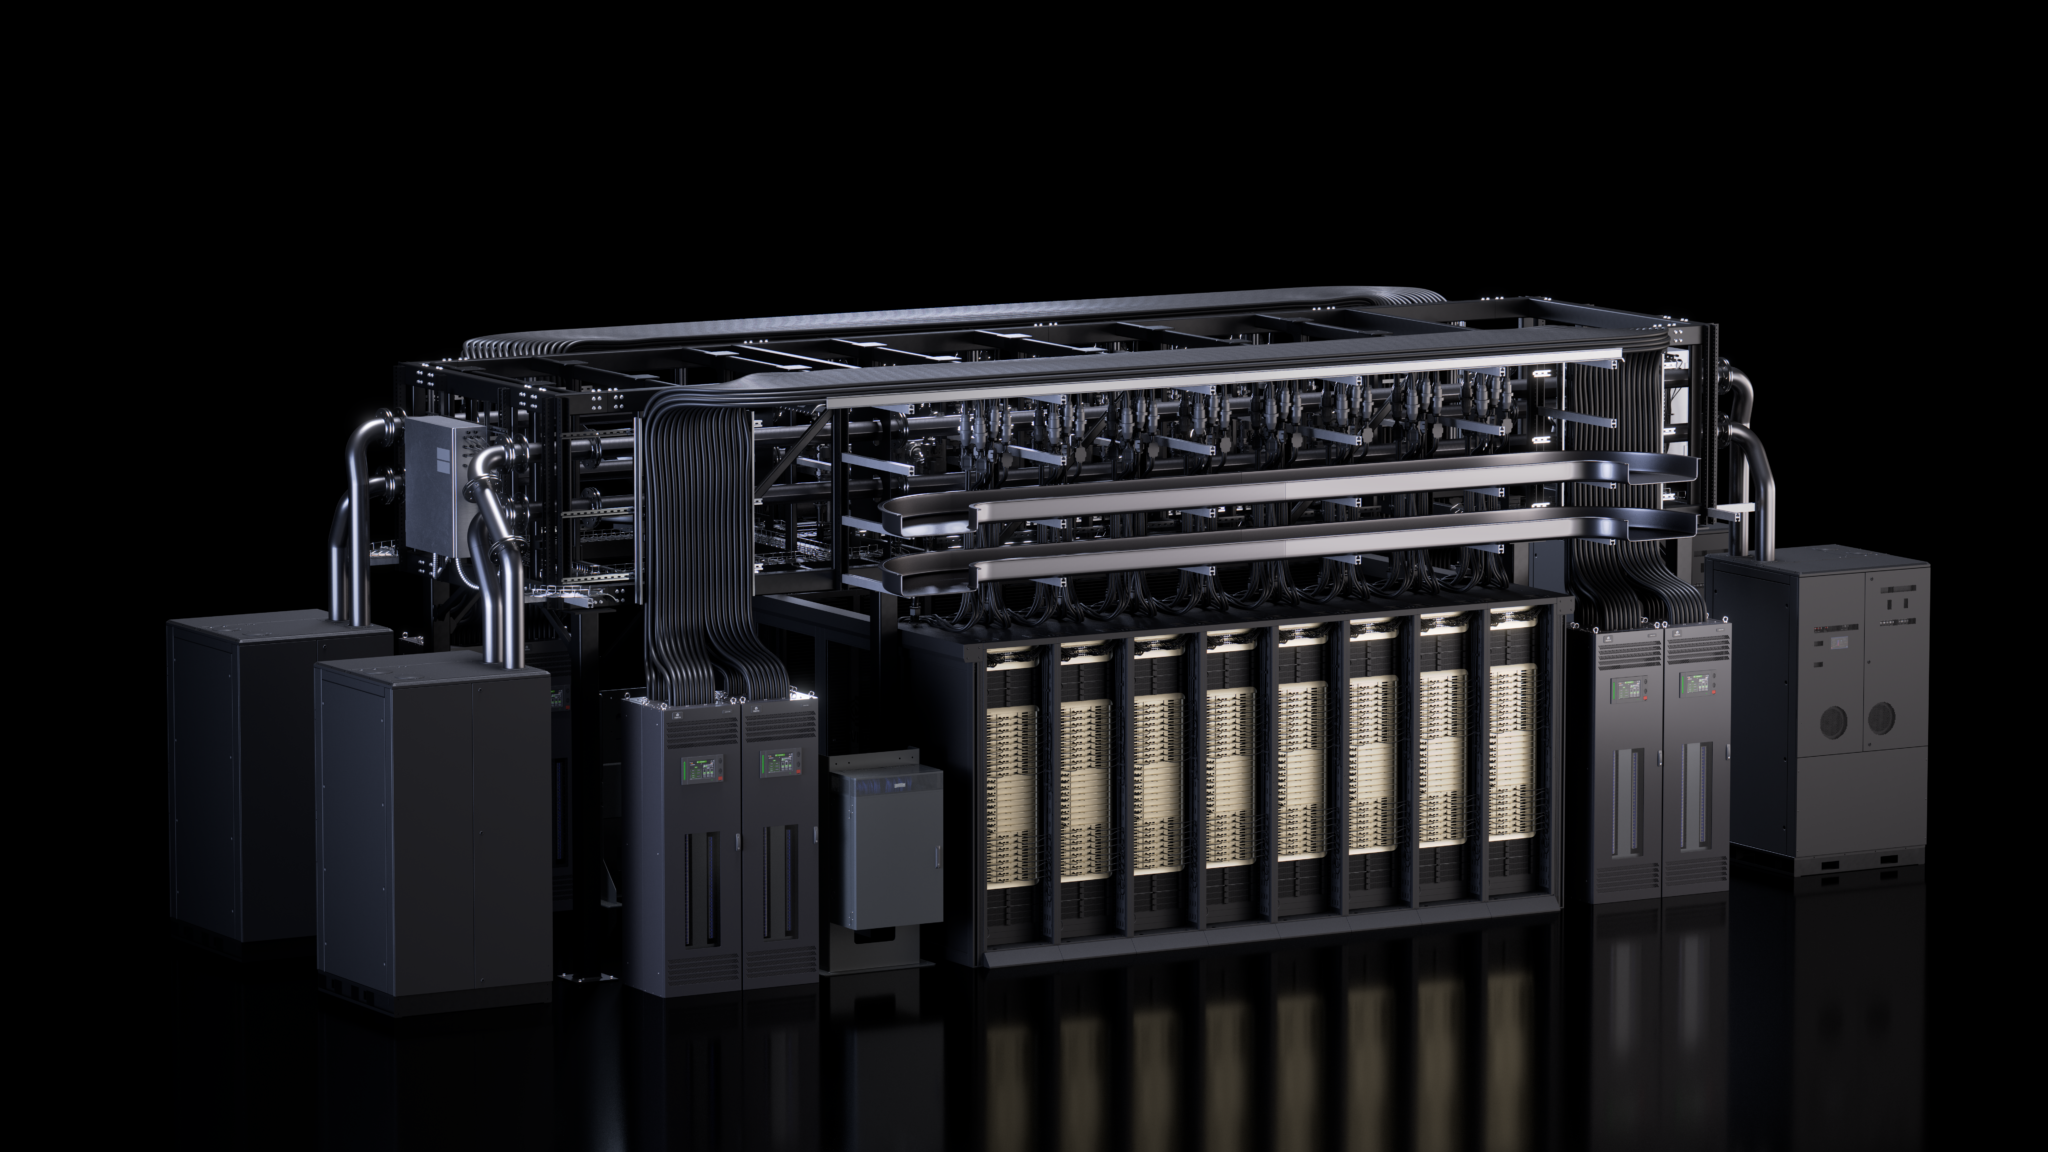
NVIDIA 与行业领导者一起,通过 OCP 的 Open DC 计划为第三代 MGX AI 数据中心参考设计做出贡献。
结合 MQD 和 MQDB 等开放式液冷技术,该举措有助于将经过验证的 AI 工厂设计转变为行业标准,供业界采用、制造和扩展。
针对 NVIDIA Vera Rubin AI 工厂,更新后的 MGX 1.2 规范将 AI 工厂的开放架构进一步延伸至机架级盲插液冷、可互操作的机架级互连基础设施,以及专为更高功率 AI 系统设计的 5000A 液冷母线槽 (busbar)。该规范还增加了对原生 19 英寸设备支持和更高密度的机架设计。
MGX 1.2 通过可配置的 I/O 插槽、无风扇液冷计算托盘、标准化的电源和冷却接口以及通用基础设施,进一步扩展了模块化,帮助生态系统合作伙伴构建可互操作的加速计算平台。其缩短了组装、测试和服务时间,简化了制造和现场服务,从而实现更快、更高效的基础设施建设。该架构支持高达 250kW 的机架部署,并简化了可维护性、部署和基础设施重用。
Vera CPU 机架设计规范将 NVIDIA MGX 开放架构从加速计算进一步拓展,为日益发展的智能体 AI 时代提供了一个专用平台。Vera Rubin 机架级系统是大规模训练和推理的基础,NVIDIA Vera CPU 机架则专为工具调用、编排和沙盒执行而设计,帮助 AI 智能体实时与应用、数据和服务进行交互。
Vera CPU 机架基于第三代 NVIDIA MGX 机架架构构建,沿用了相同的机架级设计理念,将计算、网络、供电和冷却整合到一个通用的模块化平台中。这种方法使合作伙伴能够部署专用基础设施,同时受益于共享的生态系统、简化的集成以及面向新一代 AI 工厂统一的基础。
NVIDIA 为 DSX AI Factory 推出全新开源软件组件
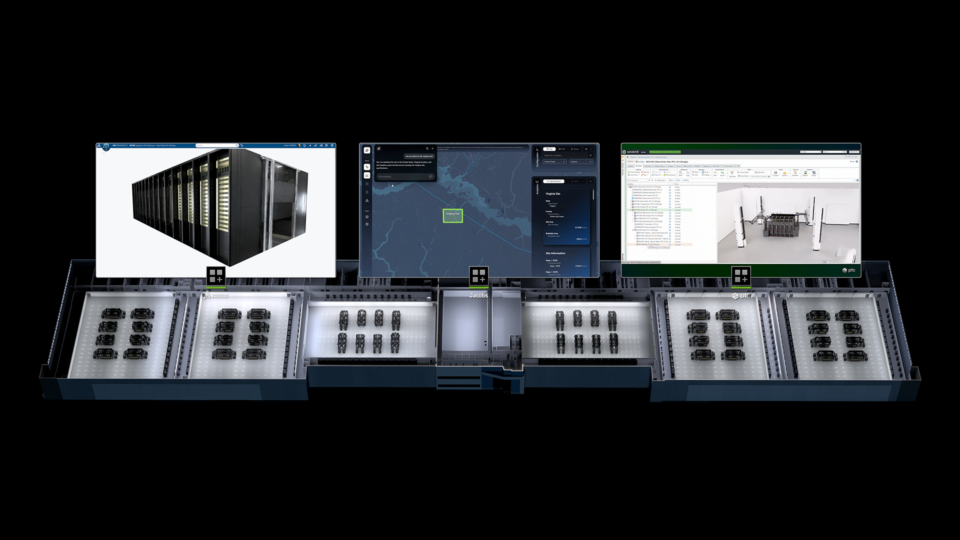
NVIDIA DSX AI 工厂平台采用极致协同设计,将计算、网络、供电、冷却、设施和软件整合,帮助 AI 工厂作为一个整体优化的系统来运行,基于可用的基础设施资源实现 AI 产出最大化。这个统一系统的核心是 DSX OS,这是一个开放的操作系统层,它让 DSX 架构能够实现规模化、协调一致且可重复的运作。
在 OCP 峰会上,NVIDIA 通过开源组件扩展了 DSX 操作系统,用于配置网络、验证集群、管理机架和调配裸金属:
- NVIDIA 配置管理器:大规模自动化交换机配置,助力客户部署、验证和维护一致的 AI 工厂网络,将人工干预降至最低。
- NVIDIA 集群就绪引擎:借助真实的工作负载模拟对 GPU 集群进行压力测试,在训练任务开始前保证硬件正常运行,从而有效避免因故障导致代价高昂的任务崩溃。
- NVIDIA 机架管理服务:提供机架硬件抽象和运维解决方案,将机架作为头等核心单元,以提升 AI 工厂大规模固件管理。
- 适用于 NVIDIA 基础设施控制器的集群 API Provider:加速裸机部署和租户载入,将原始 AI 硬件转变为生产就绪型集群的时间从几天缩短到数小时。
这些开源组件基于 NVIDIA 运行 NVIDIA DGX Cloud 的经验而开发,助力云服务提供商和软件合作伙伴能够将 AI 工厂能力直接集成到其多租户平台中。
开发者可以访问 DSX AI Factory Github 页面,探索 NVIDIA DSX AI Factory 平台上全新或现有的开源软件组件并为其做出贡献。
NVIDIA 与超大规模企业共同发布新一代 AI 工厂开放标准
要实现 AI 基础设施在全球范围内的规模化扩展,仅有先进的硬件是不够的,还需要一个整个行业能够共同构建的通用基础。
在 OCP 峰会上,NVIDIA 与 AMD、谷歌和 Meta 共同发布了一项新的开放规范,为此类基础设施奠定了基础。开放数据中心规范 v0.7 为新一代 AI 工厂设施设计制定了统一蓝图,从供电架构到冷却基础设施,再到物理布局等方面。
这项由谷歌、Meta、微软和 NVIDIA 共同发布的 OCP 电网可靠性规范,明确了大规模 AI 基础设施在公用电网扰动期间应具备的行为能力:保持连接、自动响应,并在两秒时间内恢复至接近满载运行状态。
随着这些标准正式开放,全球制造商拥有了统一的研发目标。设备制造商、托管提供商和数据中心运营商可以开始设计、制造和交付支撑全球在建 AI 工厂的基础设施层,而无需等待各个客户的专有规范。
这些规范兼容 NVIDIA DSX 参考设计,为上述规范提供了经过验证的、可部署的实现方案,从设施布局和供电架构到实时监控和响应电网信号的软件。对于正在建设 Vera Rubin AI 工厂的运营商来说,如今从开放社区标准到实际运行的系统之间,已经有了一条清晰的落地路径。
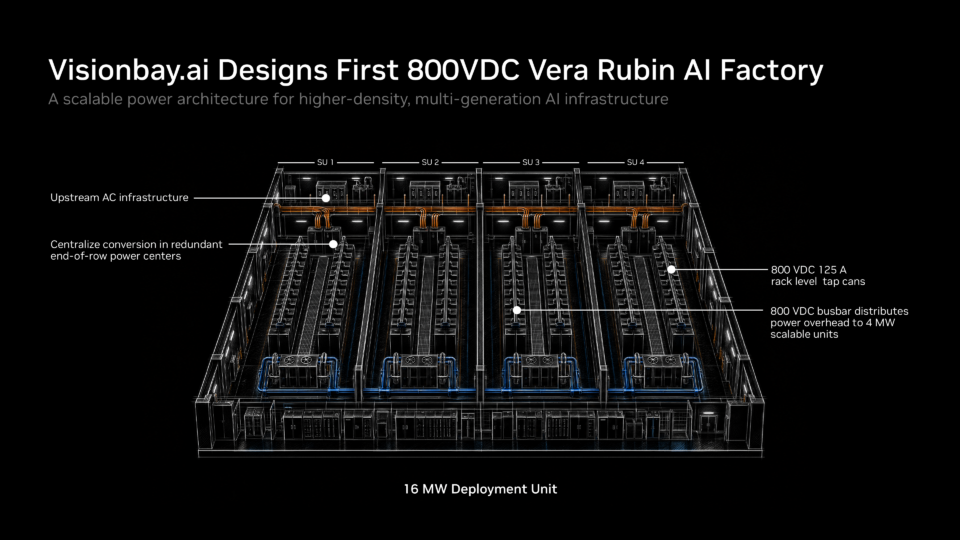
Visionbay.ai 为 Vera Rubin 时代打造 800VDC AI 工厂
随着 AI 工厂的规模与算力不断攀升,一个共同的挑战日益凸显:如何为推动新一代 AI 的加速计算系统提供足够的电力。
在 OCP 峰会上,Visionbay 公布了 K-1 —— 新一代 AI 工厂平台的计划。该平台围绕 800 VDC 架构并针对未来的 NVIDIA Vera Rubin 部署进行构建。该项目将 NVIDIA 800 VDC 参考架构与 Vertiv 的供电和散热技术相结合,为高密度 AI 基础设施奠定了可扩展的基础。
该设计旨在解决日益严峻的行业挑战。随着 AI 训练、常规推理和深度推理工作负载的增加,机架功率密度不断上升。传统的低压配电变得越来越难以扩展,需要更多的铜缆、线缆和电源转换设备。
通过采用 NVIDIA 800 VDC 架构,K-1 为更高密度的 AI 基础设施开辟了一条可行路径,同时兼顾了现有部署的灵活性。该平台不需要在部署初期就完成完全过渡,而是设计为分阶段采用 800 VDC 配电的策略,从而提供最大的优势,帮助运营商为未来几代加速计算做好准备,而无需大规模重新设计设施。
该架构围绕集群级供电中心设计,将交流到直流 (AC – DC) 的 转换集中处理,并将 800 VDC 分配到更接近计算资源的位置。该方法简化了下游电力输送,支持模块化扩展,并为未来 AI 工厂的发展创建可复用的基础模块。
K-1 体现了 NVIDIA AI 工厂背后的系统级设计理念,即将供电、冷却和计算相结合。该项目支持液冷基础设施、可扩展配电和未来的 Vera Rubin 级部署,展示了生态系统合作伙伴如何将 NVIDIA AI 工厂架构转换为可部署的基础设施,专为新时代的加速计算而设计。
Meta 和 NVIDIA 利用 Spectrum-6 和多平面技术推动 AI 网络的发展
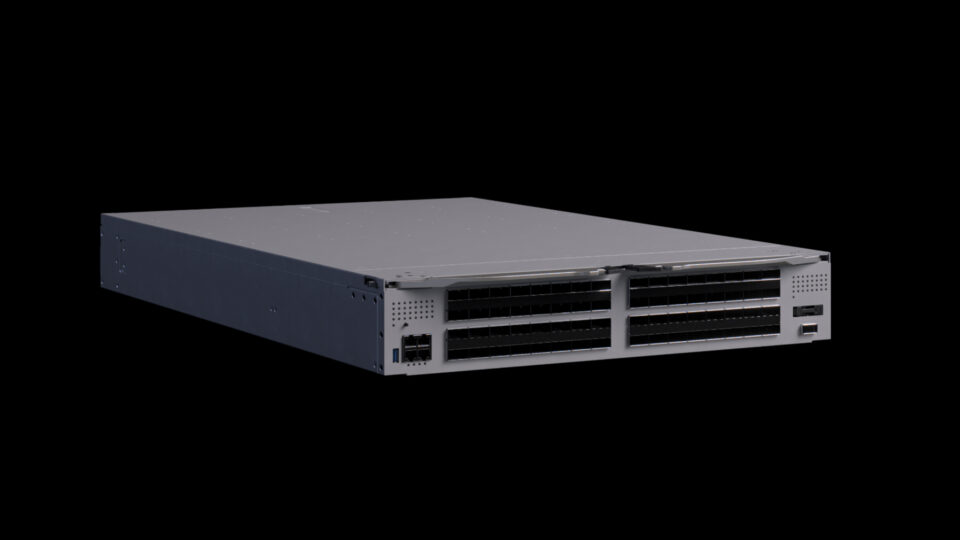
在本次活动中,Meta 和 NVIDIA 宣布 Meta 将采用 NVIDIA Spectrum-6 102.4 Tb/s 以太网交换机,在开放网络上构建更大、更高性能的 NVIDIA Vera Rubin AI 工厂。
Spectrum-6 的交换容量和单通道带宽是 Spectrum-4 的两倍,并提供单通道 200G 的无损以太网 AI 网络,支持高效的带宽和性能隔离,可确保一项任务的流量不会干扰另一项任务的运行速度。
Meta 基于 Spectrum-6 的交换机 N-IceCube,将集成到 Meta 的 100T 液冷机架 IcePack 中。N-IceCube 运行 Facebook 开放交换系统 (FBOSS),这是 Meta 向 OCP 提供的开源网络操作系统,旨在支持超大规模的高效网络。
FBOSS 基于交换机抽象接口 (SAI) 构建,该接口是 NVIDIA 协助开发的 OCP 标准,提供了一种独立于供应商的交换机硬件控制方式。这些技术共同支持由超过 10 万块 GPU 组成的智能体 AI 工厂,这些 GPU 可训练和服务于大规模混合专家模型。
此次合作将 Meta 的超大规模 AI 基础设施运营经验与 NVIDIA 的网络技术相结合,标志着双方合作迈出了新的一步。
此次合作的核心是 Spectrum-X 多平面技术,该技术由 Spectrum-6 交换机和 ConnectX-9 SuperNIC 提供支持。多平面技术能够在硬件层面将 GPU 流量分配到多达 8 个独立的网络平面,使 AI 工厂能够在减少交换机层和基础设施成本的同时,扩展至超过 10 万块 GPU。GPU 之间的多路径可提高网络利用率和可靠性:当某个组件发生故障时,流量可转移到剩余平面,从而确保 GPU 保持生产力,AI 应用程序也可以继续运行,即使带宽有所降低。
Meta 和 NVIDIA 共同通过部署经验和快速工程迭代,增强了可靠性。双方团队已在本地和云环境中验证了相关改进。
Meta 数据中心与 AI 网络高级总监 Omar Baldonado 表示:“我们很高兴能与 NVIDIA 密切合作,使多平面网络在运营层面兼具可扩展性和高性能,这对我们自身的基础设施建设和联合云合作伙伴而言都至关重要。将 FBOSS 扩展至 Spectrum ASIC 意味着我们可以在网络上运行相同的软件栈,而 Meta 基于 Spectrum 的全新交换机 N-IceCube 将这一点引入了 Icepack。Icepack 是我们面向横向扩展的 102.4 T 液冷网络机架,可为新一代加速器提供连接支持。”
Meta 与 NVIDIA 正共同开发一套可供其他 AI 基础设施运营商采用的架构及运维实践指南。将把在高要求生产负载中积累的经验教训,转化为更具可扩展性、更可靠且更高效的 AI 工厂。
NVIDIA 和思科推出 USFP,为 AI 工厂规模化重塑可插拔光模块
为支持更大的模型和不断增长的推理需求,AI 工厂持续扩展。这就要求基础设施堆栈的每个组件 —— 乃至网络连接本身 —— 都必须提供更高的性能、效率和简便性。
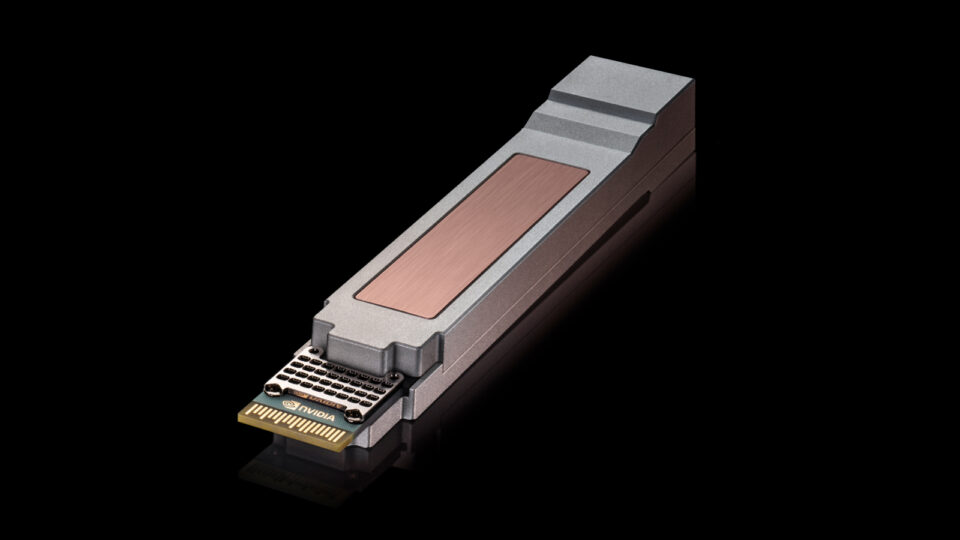
在 OCP 峰会上,NVIDIA 和思科宣布了 USFP 计划。这是一种新型可插拔光模块,旨在帮助 AI 工厂建造者扩展新一代 AI 网络,同时提高带宽密度和能效。
USFP 的空间规格与广泛采用的单通道 200Gb/s 的 OSFP 大致相同。它支持单通道 400Gb/s 网络带宽,进一步扩展基于收发器的部署模式,该模式已在多代数据中心网络中得到验证。该模块集成 16 个全双工通道,并规划扩展到 32 个通道,USFP 的带宽密度将是传统单通道 200Gb/s 可插拔光模块的 4 倍。
这意味着能够连接更多计算资源,而无需增加可能带来高延迟、功耗和复杂性的网络层。
新的封装规格专为满足新一代 AI 工厂对规模和效率的需求而设计,在支持更高带宽的网络的同时,保留了使可插拔光模块成为现代数据中心支柱的灵活性和可维护性。它还能将能效提高约 1.3 倍,帮助运营商以更低的能耗传输更多数据。
为推动开放生态系统的发展,NVIDIA 和思科正与 TE Connectivity 和 Amphenol 在笼座、连接器和模块方面展开合作,并计划通过社区主导的多源工作组推进 USFP 的发展。这些公司正共同为更具扩展性、更高效和更可互操作的 AI 工厂网络奠定基础。
Google Falcon Transport 支持 NVIDIA ConnectX-10,实现可互操作的 AI 网
NVIDIA 和谷歌宣布,未来 NVIDIA ConnectX-10 SuperNIC 和 BlueField DPU 将支持 Falcon Transport,帮助提高大规模 AI 基础设施的网络效率。
Falcon 是一种在以太网上运行的可靠传输协议,避免以太网拥塞时的丢包问题。它通过多路径负载平衡、可编程拥塞控制、硬件失包恢复和基于连接的安全机制,支持 AI 和存储工作负载。
此次合作将 NVIDIA 硬件加速技术与 DOCA 软件相结合,实现 Falcon 落地,并将 NVIDIA 网络扩展至谷歌的数据中心传输。NVIDIA 和谷歌网卡可以通过通用传输层进行通信,同时应用程序仍能保留标准 RDMA 编程接口。
通过在多条路径间分配流量、适应拥塞、丢包恢复和保护连接,Falcon 可帮助工作负载更好地利用可用带宽,并在以太网网络扩展时保持可预测的性能。
欢迎参加 OCP 峰会,了解更多关于 NVIDIA 的信息。