
NVIDIA 今日发布 Nemotron 3.5 Super VL。这款拥有 1,200 亿参数的开放模型,面向专用且始终在线的智能体,能够高速完成任务,并实现高准确率。
与其一同推出的还有两款全新边缘模型:Nemotron 3.5 Bolt 74B-A9B 24GB 针对本地智能体工作负载进行优化,旨在平衡每 GB 的智能能力与运行速度;Nemotron 3.5 Bolt E4B 4GB 则着重提升每 GB 的智能能力,适用于快速响应的对话式智能体。
Super VL 和 Bolt 74B-A9B 现已可用,Bolt E4B 将于 10 月 23 日发布。
这三款开放模型共同覆盖从大型企业级服务器到边缘端设备和本地硬件的全场景智能体部署。
如今,任何希望在 NVIDIA 基础设施上运行智能体的组织,都能获得适配相应部署层级且经优化的开放模型,无需在模型能力与部署便捷性之间取舍。
Super VL 和 Bolt 与 Lightning、Ultra 一同加入 Nemotron 系列。
Lightning 于 8 月发布,可处理高吞吐量工作负载;Ultra 可应对具有高度挑战性的推理任务;Bolt 则将智能能力延伸至边缘端。
Nemotron 3.5 Super VL:以五分之一的规模实现前沿级准确率
与 Nemotron Coalition 联合打造的 Super VL,在指令遵循、工具调用、多步骤业务工作流和视觉理解等多模态智能体任务上实现领先的准确率;与 NVIDIA 最大规模推理模型相比,其参数量约为其五分之一。
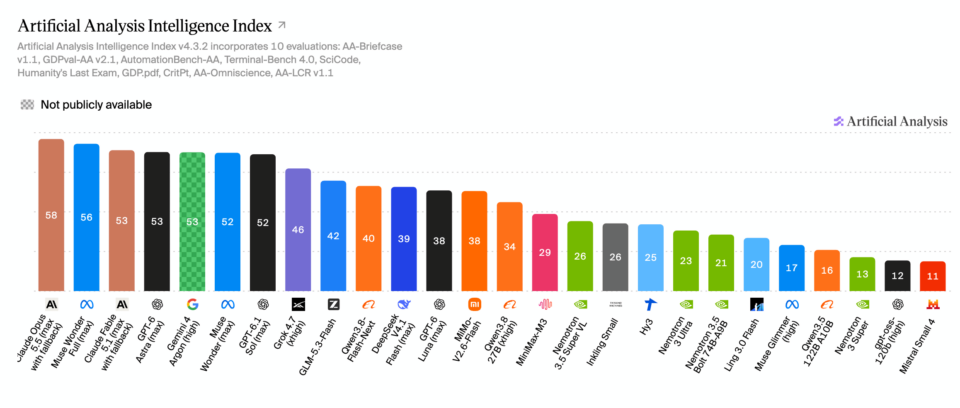
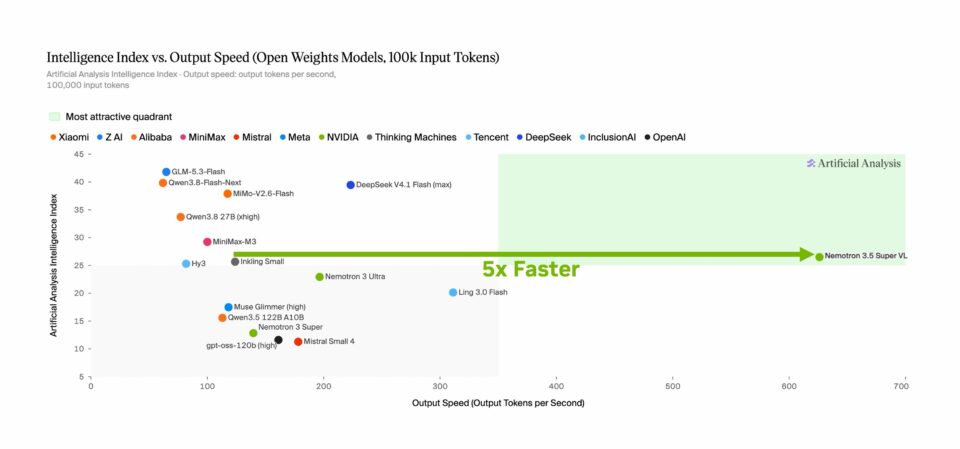
作为同级别中速度最快的开放智能体模型,其速度是较次优模型的 5 倍,可助力企业级智能体在持续数天乃至数周的工作流中更快完成海量任务。
与闭源前沿模型不同,企业可使用自有数据对 Super VL 进行后训练,将其部署在自有基础设施上,并对所构建的应用进行全面管控。
Nemotron 3.5 Bolt:边缘端的智能体智能
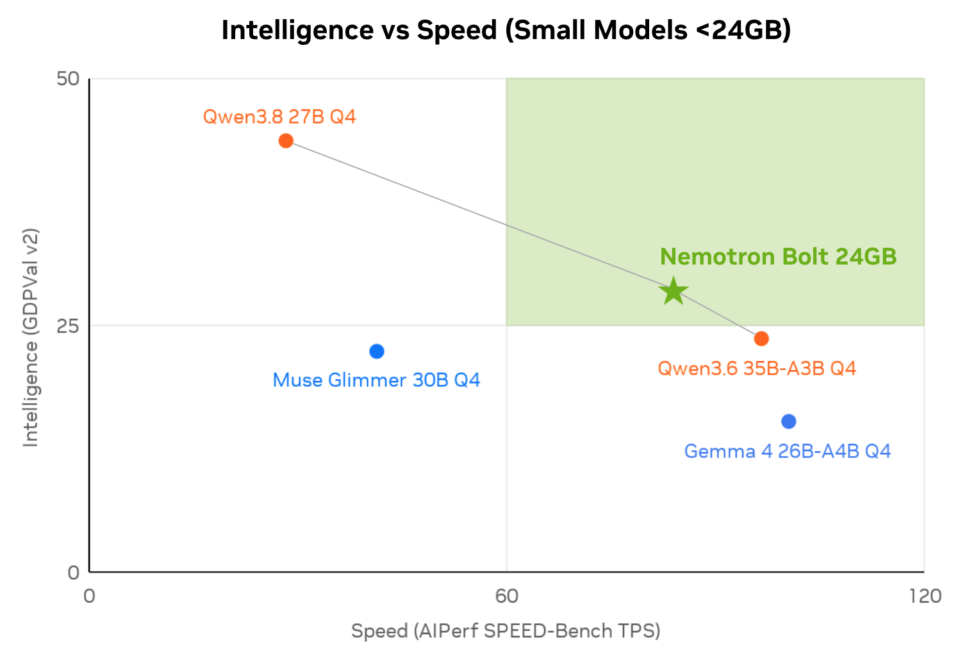
Bolt 74B-A9B 24GB 专为在 NVIDIA RTX Spark 或 DGX Spark 上本地运行日常智能体任务而设计,采用原生 2-bit 量化技术,可适配 24GB 显存,并与其他应用程序并行运行。
与内存占用相近的其他模型相比,该模型在智能水平与运行速度之间实现了良好平衡:既具备完成大多数任务所需的智能能力,又比智能模型快得多。
借助 Bolt 74B-A9B 24GB,用户可将网页研究、内容创作、代码调试等项目交由主流本地智能体 Harness 完成,无需将相关工作负载发送至云端。该模型在 PinchBench 同级别开放模型中排名第一,并在 BrowseComp 开放模型中排名第二。
Bolt E4B 4GB 专为 GeForce RTX、Jetson 和 RTX Spark 或 DGX Spark 上的物理与对话智能体打造。该模型融合自然对话与多轮智能体能力,可为快速响应的本地语音助手、交互式角色和嵌入式界面提供支持。
定制化超级智能的应用
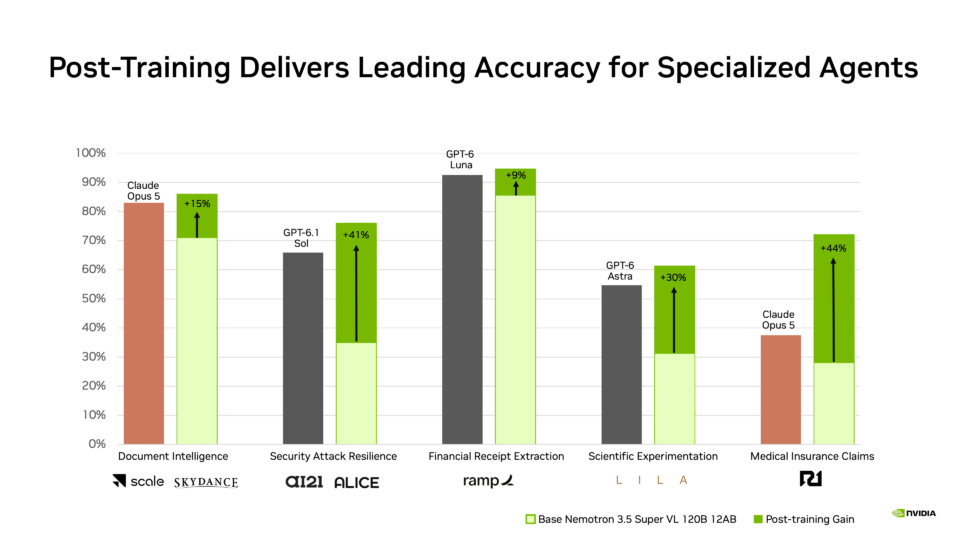
来自各行各业的数十家组织正基于自身的数据、工具、策略和工作流对 Super VL 进行后训练,以进一步提高模型在定义其智能体部署的专业任务上的准确率。
各行业内组织都在对 Super VL 进行后训练与定制。Scale AI 对该模型进行了后训练,分别用于 Skydance 的供应商信贷融资智能体和安永的并购尽职调查智能体。AfterQuery 为 Hebbia 定制了该模型,用于信贷协议分析。AI21 和 Alice 对该模型进行了后训练,以增强抵御网络安全攻击的能力。Mercor 基于 APEX-SWE 编程基准测试对该模型进行了后训练,用于能够规划、编写和调试代码的编程智能体。魔搭社区支持开发者通过其 ms-swift 框架对该模型进行微调,以构建专用多模态应用。
其他对 Nemotron 3.5 Super VL 进行定制的组织包括:Ramp,用于金融文档智能;Dream,用于 AI 驱动的网络安全研究和漏洞分析;Lila Sciences,用于科学发现与检索;以及 R1,用于医疗理赔分析和收入周期管理。TrainLoop 利用 Nolla 的皮肤科数据对该模型进行了后训练,Nolla 刚刚成为首家获准使用 AI 为患者开具初始处方的公司。
集成 Nemotron 3.5 Super VL 的软件平台公司包括:
- Atlassian:用于执行跨 Jira、Confluence 等应用的智能体搜索任务。
- CrowdStrike:正在定制该模型,用于企业安全中的智能体蓝队防御。
- 达索系统:赋能工程设计与仿真。
- Perplexity:用于 Perplexity Search 和 Computer 中的搜索与智能体任务。
- Salesforce:正在定制 Nemotron,以支持 AI 智能体通过 Missionforce Operations,在安全的客户环境中推动复杂政府工作流的数字化与自动化。
- 新思科技:其半导体设计验证软件可与该模型互操作。
Nemotron 3.5 Super VL 究竟看到了什么
Nemotron 3.5 Super VL 在视觉语言方面的优势主要针对智能体在实际应用中遇到的任务:包括光学字符识别、表格与图表以及视觉文档中的结构化信息处理。
它能够处理网页、提取文本、读取图形和图表,并根据获取的信息返回洞察。这同样适用于 PDF 及智能体常用的其他文档。
Nemotron 3.5 Super VL 能够理解图像、网页和 PDF,并据此采取行动。在单一模型中融合文本与视觉理解能力,意味着智能体无需在不同系统之间分派任务 —— 从文档到数据再到决策的整个工作流中,相关上下文信息均可保持连贯。
以开放最大化保障管控、安全与隐私
开放性与可定制性相辅相成。该模型随附开放权重、开放数据集和训练配方。
管控力体现在两个方面。组织既可根据自身的安全与数据驻留要求,在任意适合的环境中运行该模型;也选择了一个能够自主调整的模型,而不必受制于提供商的限制。
例如,在保险领域,定制化智能体可反复扫描理赔申请,识别欺诈特征;在金融服务领域,智能体可审核信用评分,并依据机构自身的信贷标准标记异常活动。模型部署于本地,数据始终保持私密。
支持通过 NVIDIA NeMo、基于 Python 的管线和开放数据集进行定制。
Nemotron 3.5 Super VL 在预训练和持续预训练阶段基于约 26 万亿个 Token 进行训练,随后使用约 380 万个样本进行后训练,并在数十种环境中开展强化学习。
NVIDIA 还在 Hugging Face 上发布了一系列开放数据集,涵盖智能体工具调用、金融、指令遵循、长上下文、公平性和视觉语言理解等领域,同时发布 NeMo Gym 中的强化学习环境。
NVIDIA NIM 将模型封装为面向生产的微服务,提供经过性能优化与验证的配置及企业级支持,并每两周更新一次安全补丁和性能改进。
借助 NVIDIA Dynamo 运行该模型,企业能够以比原来低 85% 的延迟为多达 8 倍的用户提供服务。
Nemotron 3.5 Super VL 现已在 Hugging Face、OpenRouter 和魔搭社区上线,同时也以 NVIDIA NIM 的形式提供。
可在 DGX Spark、DGX Station 和 RTX 上运行
Nemotron 3.5 Super VL 可在 NVIDIA 整个硬件栈上运行,包括用于桌面端本地智能的 DGX Spark、DGX Station、RTX PRO 和 RTX 系统,用于边缘端的 NVIDIA Jetson,并跨数据中心和云环境运行。
Nemotron 3.5 Bolt 74B-A9B 24GB 现已在 Hugging Face 上提供,并支持 llama.cpp、Ollama、LM Studio、Unsloth 和 vLLM。该模型专为 10 月 16 日上市的 NVIDIA RTX Spark 笔记本电脑打造,同时也可在 GeForce RTX PC、DGX Spark、DGX Station 和 RTX PRO 工作站上运行。
下载开放权重,借助 NVIDIA NeMo 探索定制资源,或阅读技术博客,全面了解完整架构解析。
及时了解智能体、NVIDIA Nemotron 等最新动态,请订阅 NVIDIA 新闻并加入社区。
请参阅软件产品信息的注意事项。