
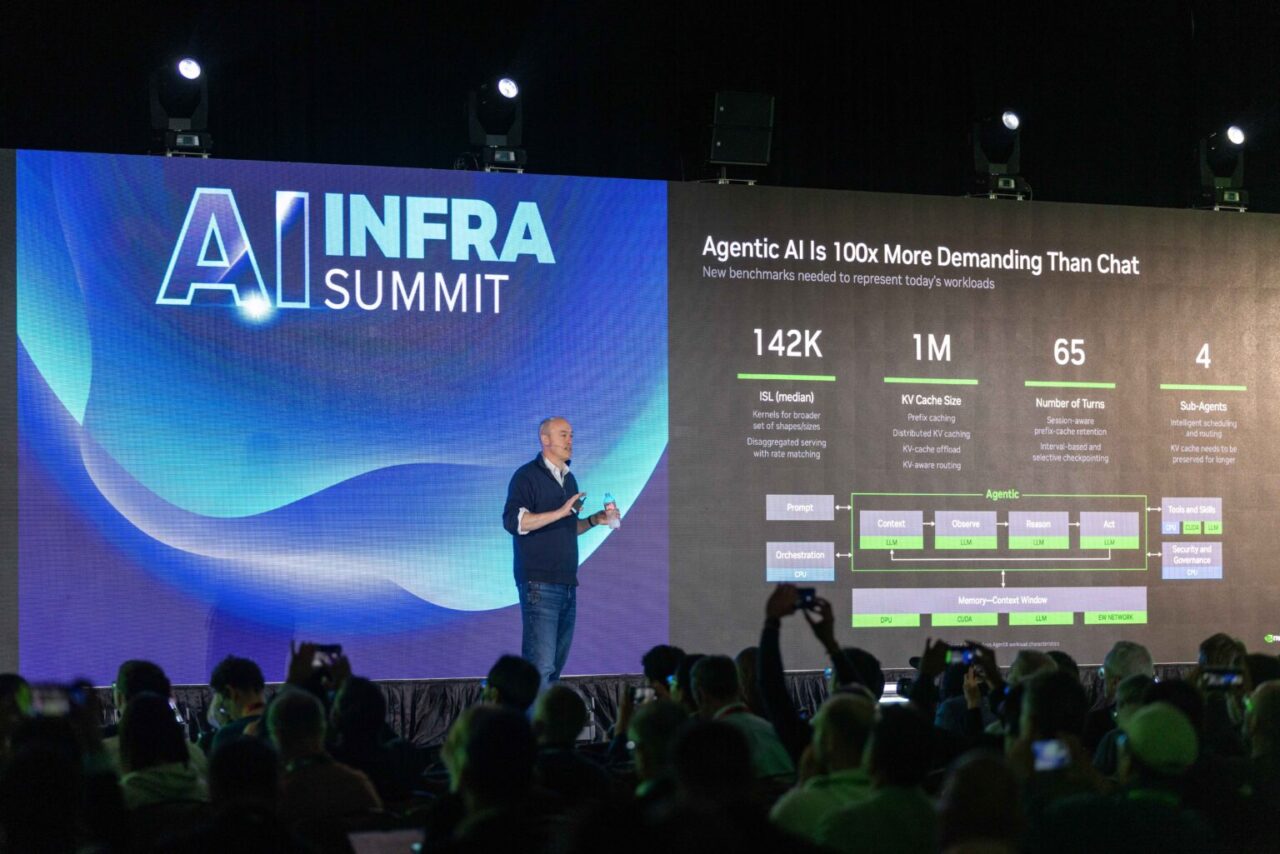
NVIDIA 超大规模和高性能计算副总裁 Ian Buck 在 AI 基础设施峰会上就 AI 工厂效率发表了演讲。这场在圣克拉拉会议中心举办的活动,已演变为基础设施科技领域的“科切拉音乐节”。
Buck 在众多观众面前介绍了跨 NVIDIA 平台等领域的新合作,今年的与会者人数从去年的 3500 人增加至 8000 多人。
- Amazon 旗下的 Annapurna Labs 正在与 NVIDIA 合作开发 NVHBM 定制高带宽内存技术。
- d-Matrix 正在采用 NVLink Fusion,将 NVIDIA Vera CPU 与 d-Matrix Raptor XPU 相集成,支持大规模提供超低延迟推理。
NVIDIA 及合作伙伴也公布了新成果:
- Emerald AI 与 NVIDIA 联合 Silicon Valley Power,展示了一项商业 AI 工厂灵活负载计划。
- 借助 NVIDIA DSX MaxLPS,Lambda 将每瓦特性能提高了 23%。
- Pinterest 正在使用 NVIDIA Blackwell 平台和 NVIDIA Dynamo 推理软件将对话式 AI 引入视觉搜索领域。
智能体 AI 正在推动一种新型工作负载,这些工作负载对 AI 基础设施的性能、效率和规模提出了更高的要求。
NVIDIA 通过涵盖 Vera Rubin 系统、Dynamo 推理软件、NeMo 库和 NVIDIA 网络的全栈 AI 工厂平台应对这一挑战,包括用于纵向扩展计算的 NVIDIA NVLink、用于连接数千个节点的 Spectrum-X 以太网和 ConnectX SuperNIC、由 BlueField 提供支持的上下文记忆存储以及用于基础设施安全的 BlueField DPU。
AI 基础设施的衡量标准正在迅速从峰值性能转变为每兆瓦验证的智能体 Token。AI 工厂现在必须从芯片到电网进行协同设计。NVIDIA DSX MaxLPS 能够通过全厂级的电源优化,将每兆瓦的 Token 产出提升多达 1.4 倍,NVLink 则可将大规模加速计算整合为统一的高性能计算系统。
因此,AI 基础设施旨在生成更多 Token、提高效率,并帮助客户从每兆瓦的电力中获得更多价值。
2026 年 9 月 15 日 
AI 工厂灵活负载计划释放更多电网功率
Silicon Valley Power 实施灵活负载互连计划,使 AI 工厂能够支持电网灵活性。
通过该计划,Emerald AI 与 NVIDIA 合作,在 Silicon Valley Power 演示了自动负载降低功能。该系统成功响应了来自 Silicon Valley Power 的数百个需求信号,同时保护了 AI 工作负载性能。
NVIDIA 合作伙伴 Emerald AI 计划将 NVIDIA DSX Flex 用于其 Connector 电网响应型电源管理软件,该软件可根据实时电网信号和混合能源动态调整 AI 工厂的能耗。
通过使用 DSX Flex 实现自动负载平衡,Emerald AI 展示了其自动降低低优先级 AI 作业功耗并随后恢复正常的能力。
DSX Flex 可以接收负载卸载请求、需求响应事件和定价信号等网格信号,并在预定义的工作负载层次结构中自动采取行动。最关键的作业会持续进行,而其他作业则会暂时暂停,随后恢复。通过这种方式,设施可以参与提高电网的能效。
这种能力使 AI 工厂能够作为灵活的电网资源运行:它们可以在电网需要缓解压力时减少需求,同时保障高优先级的 AI 工作负载,并证明可控的 AI 负载可以帮助释放更多的电网容量以促进增长。
了解更多关于 Emerald AI 与 Silicon Valley Power 的合作信息。
2026 年 9 月 15 日
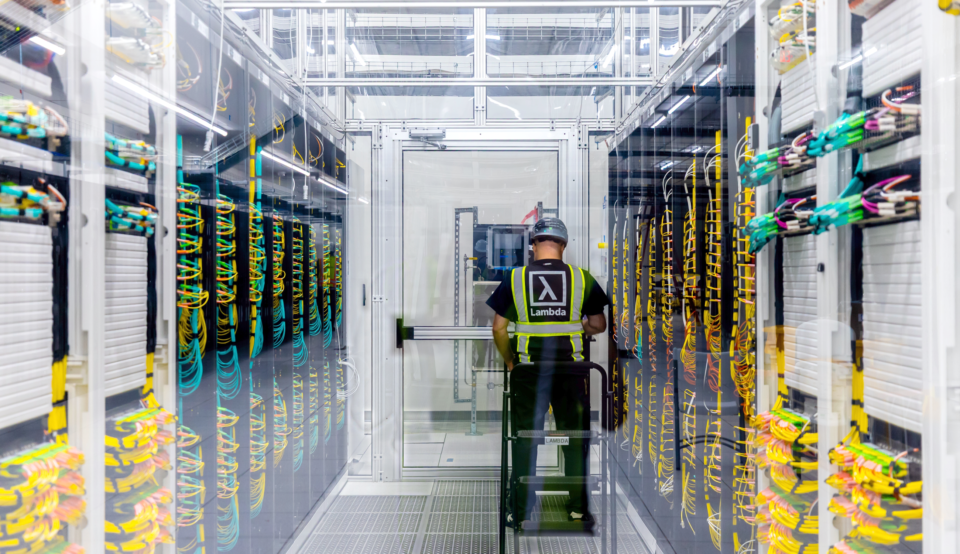
Lambda 借助 NVIDIA DSX MaxLPS 更大限度地提高每瓦性能
AI 云提供商 Lambda 在 AI 基础设施峰会上发布了结果,首次验证了 NVIDIA DSX MaxLPS 在 NVIDIA Blackwell 服务器上的表现。
DSX MaxLPS 持续监控 GPU 和机架的功耗,动态将可用功率调配至最需要的地方,并回收静态配置未使用的容量。由于训练和推理工作负载具有不同的功率配置,MaxLPS 可针对混合工作负载 AI 工厂优化功率分配。
测试结果显著:Lambda 在原本仅够 16 个全功率节点使用的相同功耗预算下运行了 19 个节点,将集群整体 Token 吞吐量提高了 24%——从每秒约 400 万个 Token 提高到 500 万个 Token,同时将每瓦性能提高了 23%。对于新一代 NVIDIA Vera Rubin 系统搭建的 AI 工厂,DSX MaxLPS 可以在合适的部署环境中,以相同的兆瓦级预算内将 GPU 容量提升高达 40%。
这意味着 AI 工厂运营商可以在相同的功率范围内提高 AI 容量和 Token 吞吐量,帮助更大限度地提高每兆瓦的生产力和经济价值。
了解更多关于 Lambda 测试结果的信息。
2026 年 9 月 15 日
Vera Rubin 和 Groq 3 LPX 将更多电力转化为 Token
在 AI 工厂中,电力是核心瓶颈。每瓦都很重要,因此,如何从每兆瓦中提取更多 Token,是 AI 基础设施的关键。
NVIDIA 通过基于 Vera Rubin 系统构建的全栈 AI 工厂来实现这一点,即系统、网络、软件和电源管理作为一个整体。在工厂层面,NVIDIA DSX MaxLPS 随着需求的增加和减少,在机架之间动态转移功率。
回报是巨大的:
- 在相同的站点功耗范围内,GPU 数量最多可增加 40%
- Token 吞吐量提升高达 35%,无需新电源线
在每个机架内,Intelligent Power Smoothing 软件和扩展的能量缓冲可吸收短峰值,使系统更接近持续需求。搁浅空间成为高效计算。
对于智能体 AI 而言,智能体需要串联多个推理步骤和工具调用,延迟和上下文长度会快速累计叠加。这就是 NVIDIA Groq 3 LPX 专为 Vera Rubin 添加了确定性超低延迟推理,并与 DSX MaxLPS 形成互补。组合后的平台在运行 2 万亿以上参数模型的长上下文任务时,每兆瓦 Token 吞吐量最高可达 NVIDIA Grace Blackwell 机架级系统的 35 倍。
数字说明了这一点。在 10 万个上下文的 Qwen 3.8 27B 工作负载中,Groq 3 LPX 达到了每位用户每秒 2529 个输出 Token。这种空间允许智能体在相同的响应预算内运行更多推理步骤和工具调用,即使工作负载规模扩大也是如此。
2026 年 9 月 15 日
初创公司对 NVIDIA Vera CPU 的卓越性能表示赞赏
初创公司正在对 NVIDIA Vera CPU 进行测试,以运行智能体工作负载和其他要求严苛的应用,并对其测试结果表示赞赏。
Perplexity 针对其面向代理式 AI 的全新 SPACE 安全沙盒平台,对 Vera CPU 进行了基准测试,结果显示沙盒启动速度提高 1.9 倍。
Daytona 借助 Vera CPU 处理智能体工作负载,并表示“其为智能体执行效能带来了显著提升”。
ClickHouse 公布了 Vera CPU 在其分析型数据库的开源基准测试 ClickBench 上的测试结果。Vera 是该团队迄今为止测得的性能最快的机器。ClickHouse 表示:“这充分展现了数据密集型工作负载 CPU 性能的未来发展潜力。”
DeepInfra 对 Vera CPU 进行了多项基准测试,结果显示其在所有指标上均表现出色,包括将编排步骤延迟加快了 2.2 倍。
Prime Intellec 发现,随着并行运行的工作负载增加,Vera CPU 保持了高带宽和低且稳定的内存延迟,这是智能体 AI 所需的可预测性能。
Redpanda 表示,Vera CPU 的基准测试显示,与其他 CPU 相比,其延迟降低约 18.1%,吞吐量提高了 73%。
Starburst 发布的基准测试结果显示,Vera CPU 的查询吞吐量比其他 CPU 快 3 倍。
与传统 CPU 相比,Kinetica 借助 Vera CPU 实现了 2.7 倍的分析查询性能提升。
2026 年 9 月 15 日
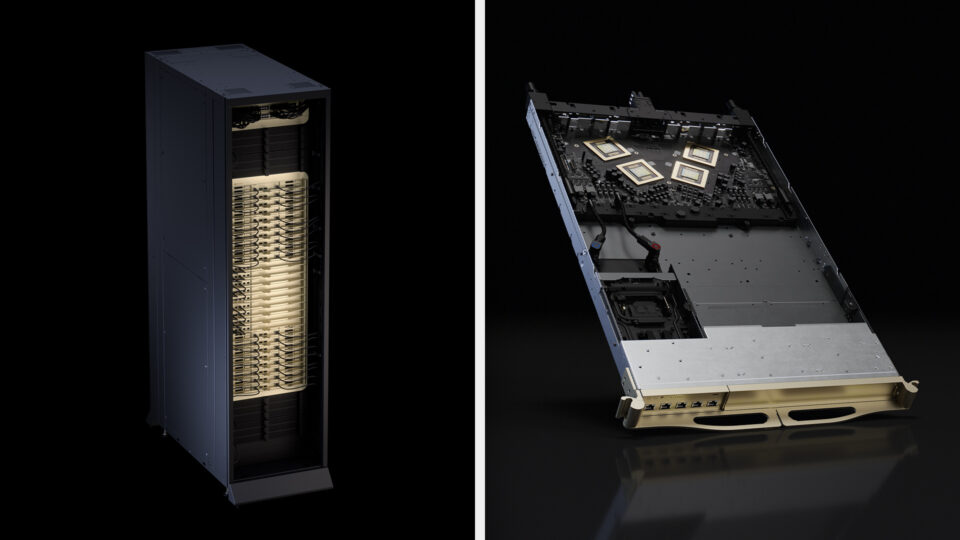
NVIDIA NVLink 6 保障超大规模 AI 工厂持续稳定运行
随着 AI 工厂扩展至数十万个 GPU,可靠性已成为一项性能特性。
训练和推理工作负载依赖持续运行,因而瞬时错误、信号劣化和硬件故障成为不可避免的挑战。NVIDIA NVLink 6 通过多层可靠性架构应对这些挑战,可在故障影响应用之前,对其进行检测、隔离并恢复。
在物理层,自定义前向纠错、物理层重试和通用物理层恢复,有助于维护无损网络,并将延迟的影响降至最低。在网络层,基于信用的流控、动态路由和链路再平衡,可将故障隔离在局部范围内,并防止发生链式停滞从而降低 AI 工厂吞吐量。
了解更多关于 NVIDIA NVLink 6 的相关介绍。