
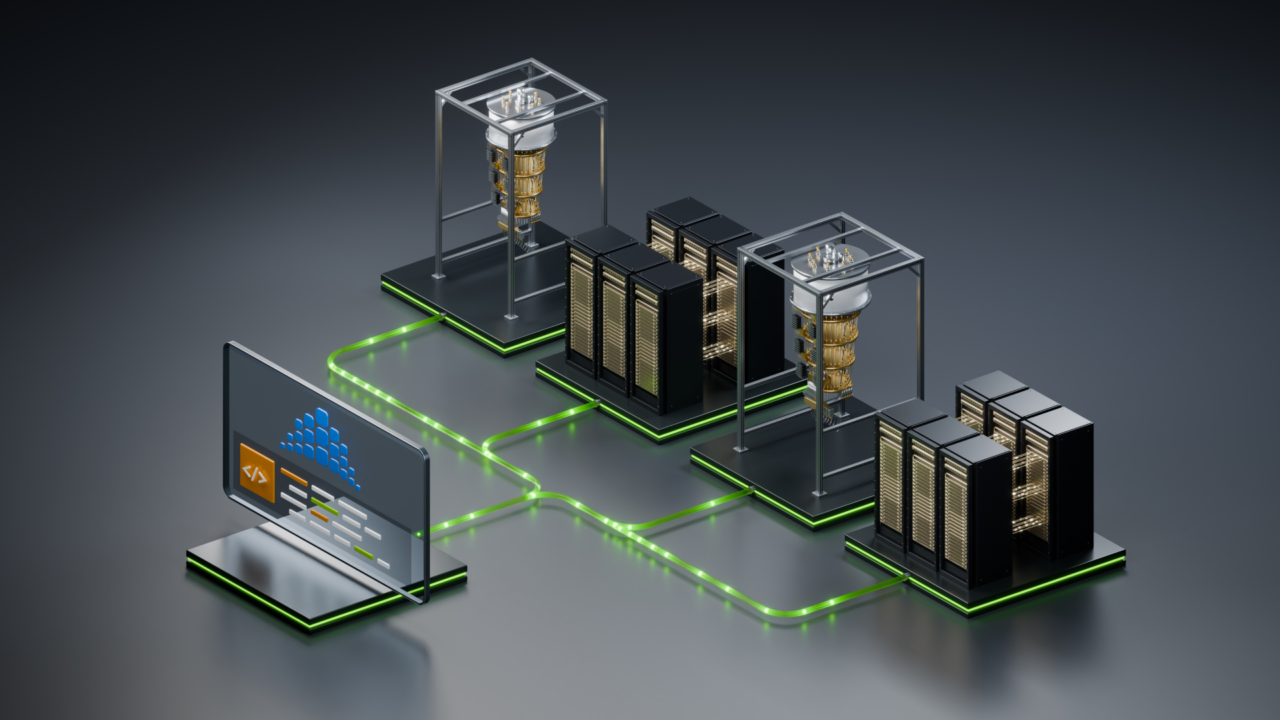
过去五年,超算中心的量子处理器部署量增长了近 7 倍。目前,全球已有近 30 家超算中心正在部署超过 50 个量子处理器。
这些中心大多使用 Slurm 来运行科学超算工作负载,因此,扩展其对量子处理器的支持,能够依托研究人员熟悉的日常工作流和工具,让计算化学家、物理学家和材料科学家能够毫无障碍地将量子计算引入他们的研究领域。
在新版本中,Slurm 在此前与 IBM、Pasqal 及更广泛的量子计算社区合作的基础上,使量子处理器制造商能够通过一个简单的配置文件,为每个超算中心创建统一的硬件接口。这让 HPC 中心和量子处理器制造商能够更便捷地集成和提供其硬件服务。
此次扩展已获得 Alice and Bob、IBM、IQM、Pasqal、Quantinuum 和 MQSC 的采用,并兼容广泛使用的 QRMI 和 QDMI 接口。
突破瓶颈
过去,将量子处理器集成到超级计算中心,意味着每接入一款新的量子处理器或新建一个超算中心,都要面临全新的软件挑战。如今,通过依托 QRMI、QDMI 等既有的量子-HPC 接口,Slurm 的扩展功能使 QPU 制造商能够在所有部署中复用现有的集成方案。这也意味着,超算中心无需再开发针对 QPU 的定制化解决方案,就能将新的量子处理器无缝接入其现有的任务调度与资源管理工作流中。
量子计算要真正推动科学进步,就需要被科学家所使用。如今,科学家可以借助 Slurm 统一调度各类所需算力,运行基于 NVIDIA CUDA-Q 等平台开发的量子-经典应用。
Slurm 26.11 预计将于本月晚些时候正式发布。
在开放量子-GPU 平台中编排资源
Slurm 的扩展为 NVIDIA 面向量子-GPU 超级计算的开放平台增加了一个由社区开发的编排层,该平台的核心是用于混合量子-经典计算的 CUDA-Q 开放平台。在 SC26 大会上,一系列全新发布对平台的各个方面进行了全面扩展:
CUDA-Q QEC 帮助量子纠错研究领域的研究人员快速构建原型并测试新思路,其中包括新增的解码器服务器。全新的 TCBP-JOBS 解码器比行业标准算法快 13,000 倍。
CUDA-Q 新增了一个容错原语扩展层,应用开发者可利用该层将其设想进行更贴近现实的编译。Fermilab 已经利用 CUDA-Q 开展了相关研究,仅用 3 周时间便完成了通常需要 5 个月才能完成的工作。
CUDA-Q Algorithms 为量子应用开发者提供了可复用的组件,新增了可帮助开发者设计量子电路的数据加载的功能,并推出了专门面向化学与材料应用的工具。
CUDA-Q Pulse 为量子硬件开发者提供了一个脉冲整形层,用于生成在 QPU 上控制量子比特所需的脉冲,并配备 GPU 加速脉冲生成的相关工具。
全球量子生态正持续围绕该平台进行构建。Quantum Motion 已将其 QUICHE 化学框架与 CUDA-Q 完成集成。Altera 与 Oxford Quantum Circuits 共同设计了一款基于 FPGA 的控制器,通过 NVQLink 将量子比特控制与读出链路接入 GPU。
在超算规模上,QunaSys 依托 ABCI-Q 上的 cuQuantum 和 1,024 颗 NVIDIA Hopper GPU,模拟了超过 3 亿次量子操作,并在四氢原子模型中实现了化学精度。NVIDIA 研究人员则利用 JUPITER 超级计算机,在真实噪声环境下模拟了 104 个量子比特,以在实际构建硬件之前测试容错量子计算设计。
了解更多有关 NVIDIA 量子计算技术的信息。