
在GTC 柏林上,NVIDIA 展示了全系列本地 AI 硬件。RTX Spark 于上周上市, 为 Windows PC 上的个人智能体提供算力支持。DGX Spark 则助力开发者在 Linux 上构建应用和扩展集群规模。
此次发布的内容包括:
- Underdog 桌面智能体现已支持 RTX Spark
- DGX Spark 64GB 将于 10 月 23 日星期五上市
- NVIDIA Sync 将于本月支持连接 8 台 DGX Spark,并新增 Model Launcher
- DGX Spark 10 月软件更新新增 Wi-Fi Assistant,并更新 DGX Spark Skills
- 全新本地编程模型 Recursive Flint 现已支持 NVIDIA 本地硬件
- 首日即支持全新 Nemotron、GLM、DeepSeek、Qwen、MiniMax 和 FLUX.3 AI 模型
- 为 llama.cpp 和 vLLM 推理引擎带来全新加速,并推出针对本地 AI 硬件优化的全新 checkpoints 。
在下方了解更多本地 AI 相关公告,并观看演示及 GTC 柏林议程。
RTX Spark 将个人智能体带到 Windows PC
RTX Spark 为 Windows PC 开启新序章,搭载至高 128GB 统一内存和 1 Petaflop AI 算力,支持运行个人智能体、加速内容创作,以及 1440p 分辨率、超过 100 FPS 的游戏体验。
自 10 月 16 日上市以来,首批评测媒体对该平台给出了以下评价:
“专业创作者梦寐以求的设备…” — CGMag
“为 AI 的未来而设计…” — The Verge
“性能强劲,便携性和能效令人惊喜…” — PCMag
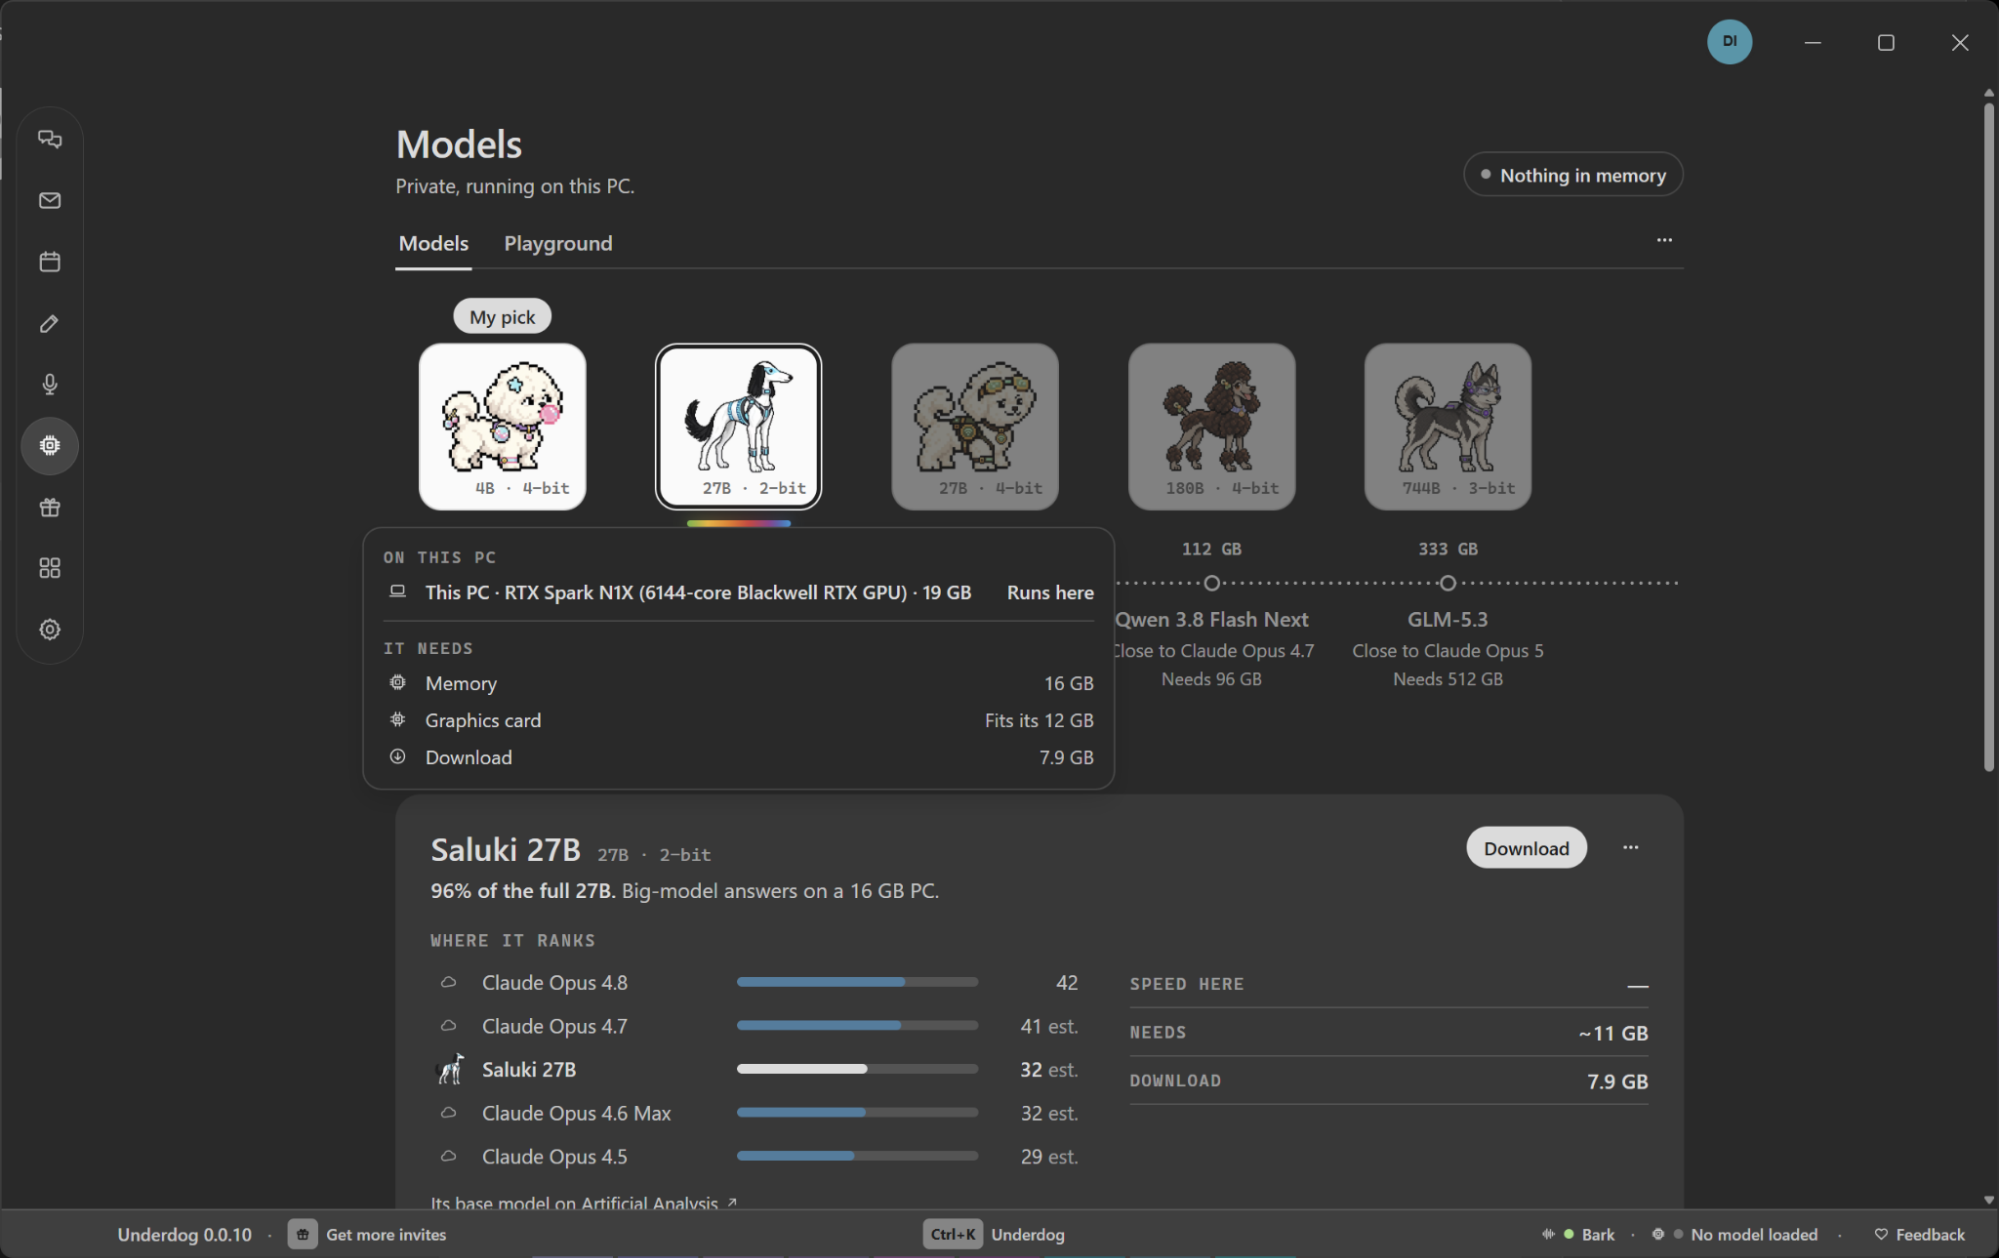
Underdog 是一款专为完全在本地运行、保护隐私的 AI 而打造的全新桌面智能体应用,也将登陆 RTX Spark。借助针对特定模型的 Husky 推理引擎,Underdog 可完全在设备上运行模型,让个人智能体完成工作,确保用户数据始终留在本地 PC。
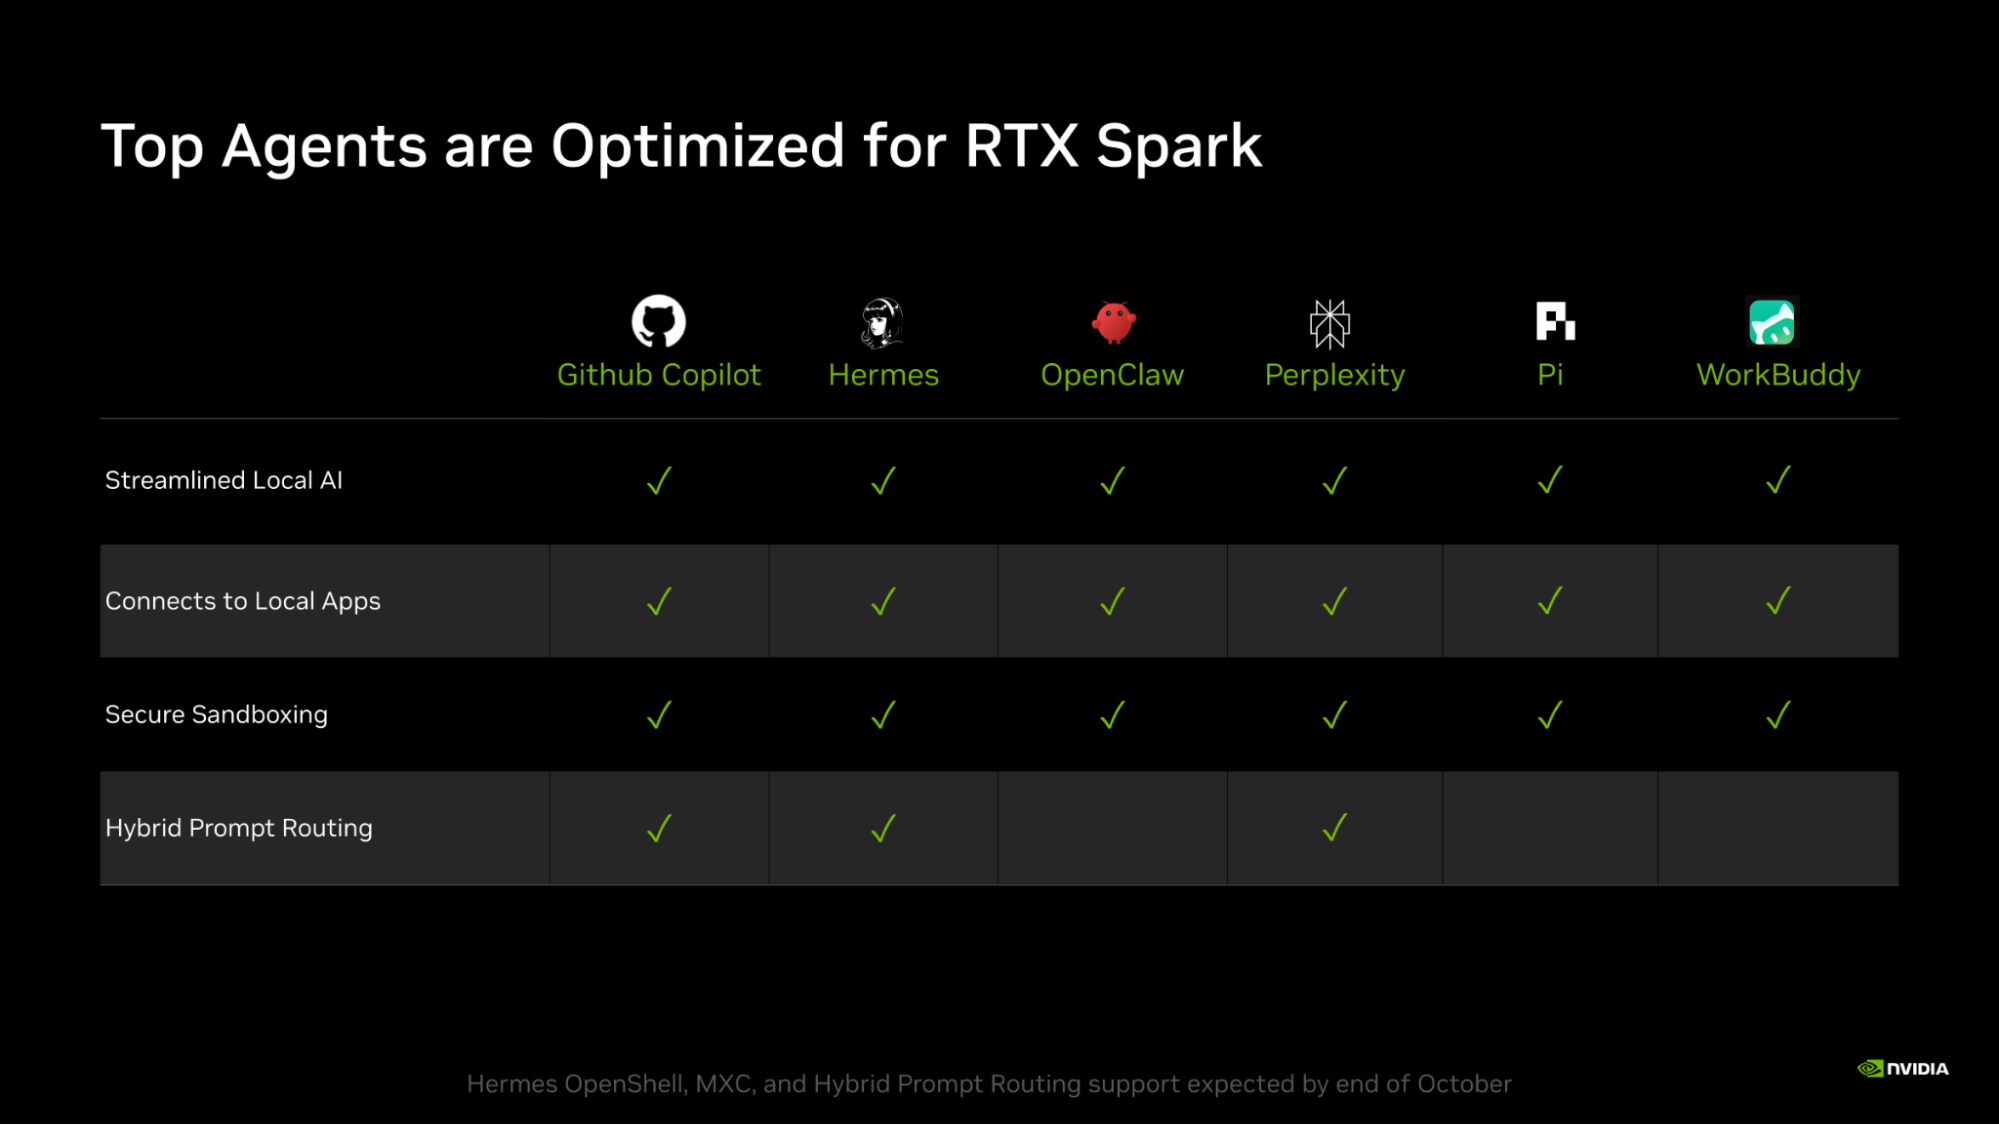
为更好地支持开发者和爱好者构建、定制本地智能体,多款 RTX Spark 笔记本电脑均配备已解锁的引导加载程序。
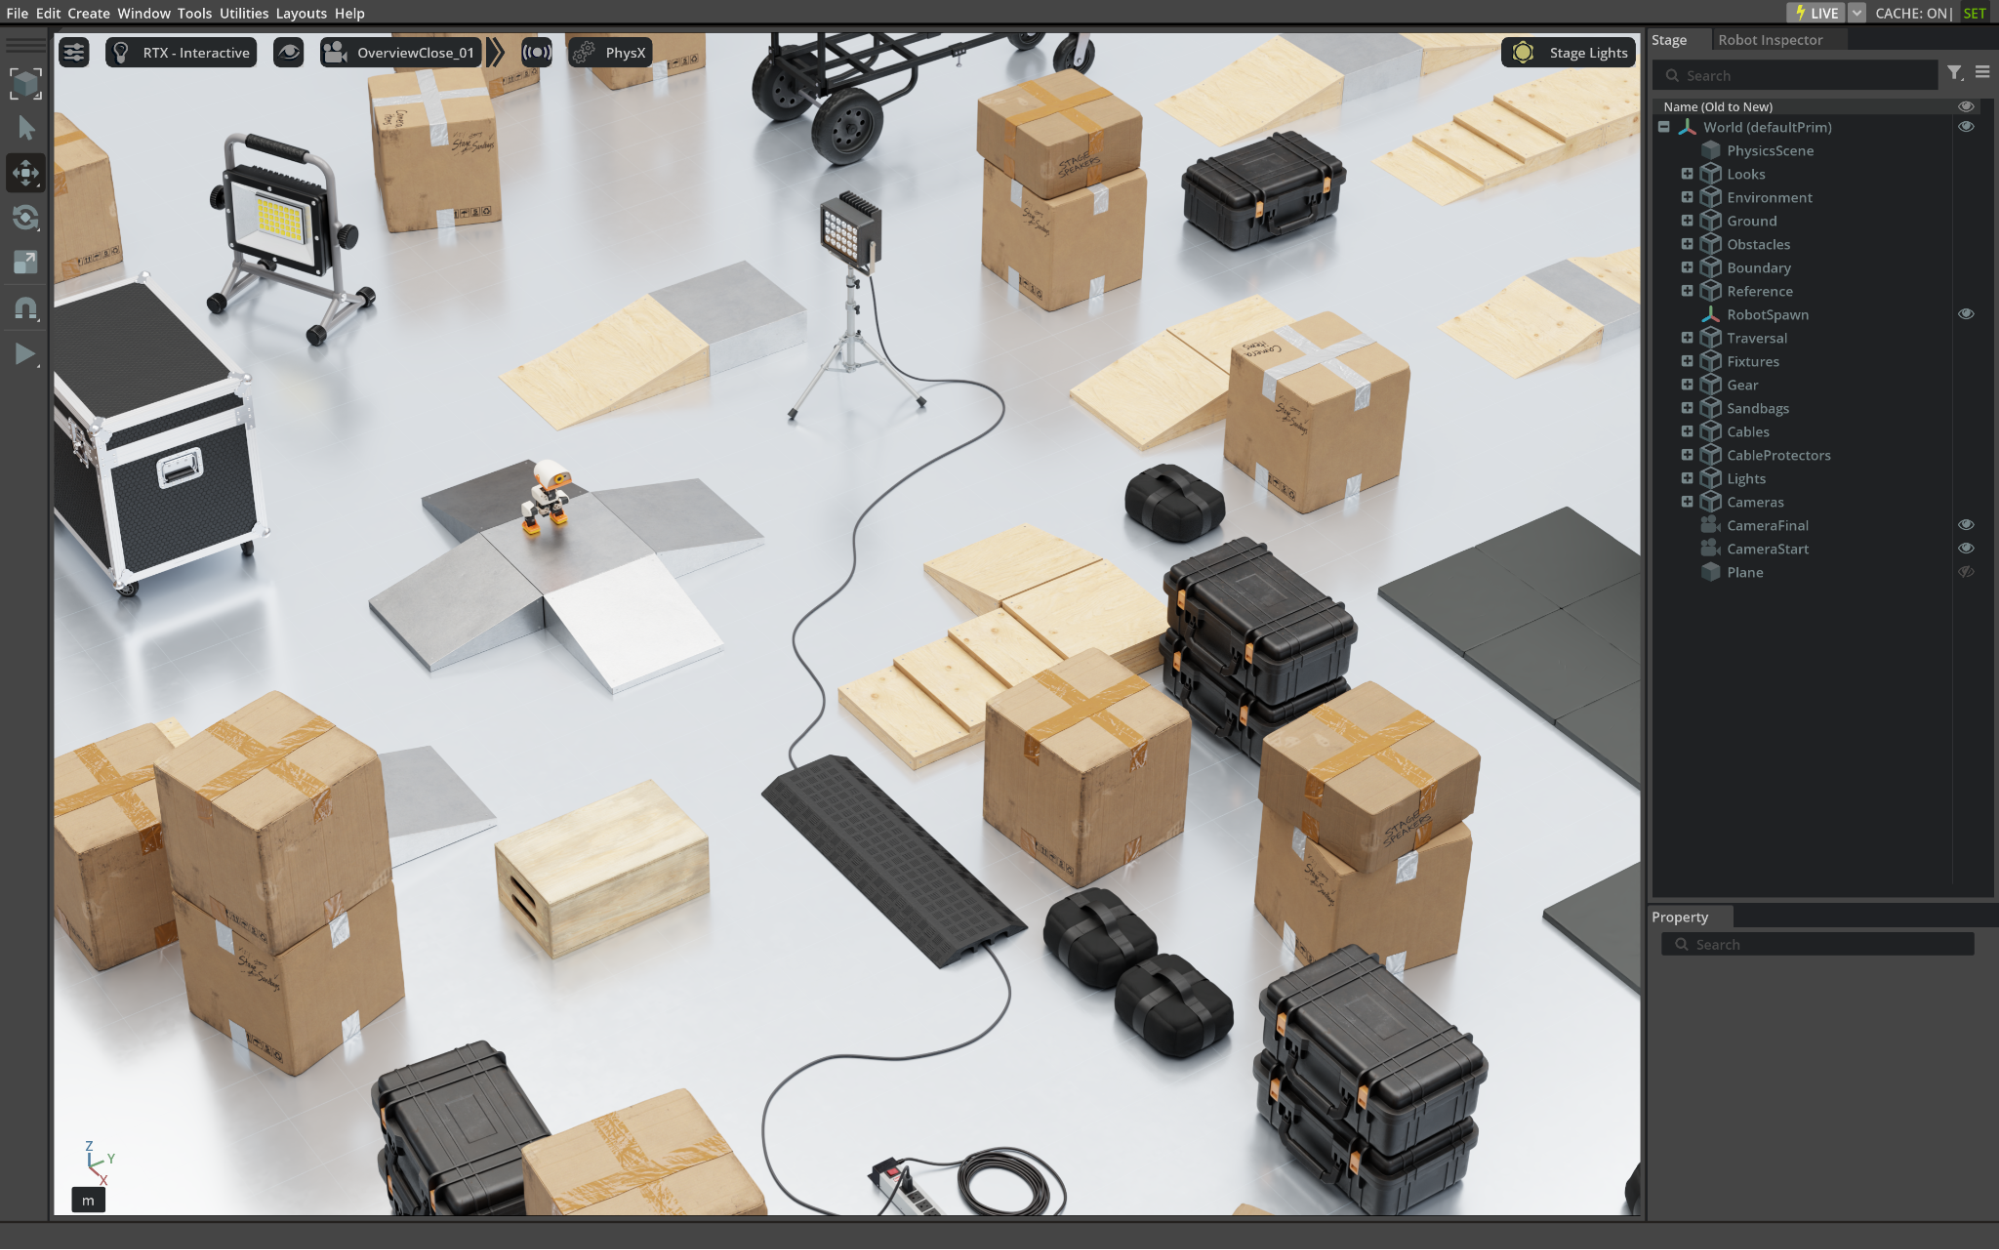
在 GTC 主题演讲中,NVIDIA 创始人兼首席执行官黄仁勋展示了如何借助在 RTX Spark 上运行的 AI 智能体,使用 NVIDIA Isaac Lab、Hermes Agent 和 Nemotron 3.5 Bolt 74B 训练 Hugging Face 的 Microduck 机器人。
华硕、戴尔、联想、微软和微星的笔记本电脑现已上市,宏碁产品也将于近期推出。
DGX Spark 为开发者提供更多开发空间
全新 DGX Spark 64GB 将于 10 月 23 日星期五起由合作伙伴陆续推出,可运行 Nemotron 3.5 Bolt 74B 24GB、Qwen3.8 27B 和 Gemma 4 26B-A4B 等模型。
当工作负载需要更大容量时,开发者可借助内置的 NVIDIA ConnectX-7 网卡和 NVIDIA Sync Cluster Assistant 连接多台 DGX Spark,运行 Qwen 3.8 Flash Next、DeepSeek v4 Flash 0731 和 GLM 5.3 Flash 等先进编程模型。
DGX Spark 现可通过手动配置组建最多 8 台设备的集群,以运行更大的模型、更长的上下文、并支持智能体的并发运行和分布式开发。该集群适合小型团队共享用作后端,让每位开发者都能针对同一模型运行并发会话。集群可提供 1TB 的统一内存,足以运行 GLM 5.3 等前沿级模型。
参阅 DGX Spark 集群 Playbook,快速开始部署。
NVIDIA Sync Model Launcher 将于本月晚些时候推出,简化在单台 DGX Spark 或集群上使用本地 AI 的流程。只需点击几下,Model Launcher 即可下载适合相应配置的模型和容器,并将模型连接到 OpenCode。它还会自动加载 DGX Spark Skills,用于故障排查、设备维护、访问官方文档,以及提供其他工作流指导。
DGX Spark 10 月软件更新带来全新的 Wi-Fi Assistant,让用户在 DGX Spark 以专用设备模式运行时切换网络。此外,DGX Spark Skills 通过 OpenCode,直接在 NVIDIA Sync 中提供面向工作流的故障排查与设备维护指导。
用户现可直接从宏碁、华硕、戴尔、技嘉、惠普、联想、微星和 NVIDIA 购买 DGX Spark。
推出 Recursive Flint —— 一款针对 RTX Spark 优化的全新本地编程模型
10 月 21 日,前沿 AI 实验室 Recursive Superintelligence 发布了 Recursive Flint,这是一款专为快速、准确编程而打造的本地大语言模型 (LLM)。 Recursive Flint 是一个拥有 400 亿参数、25 亿活跃参数的混合专家模型 (MoE),在 64GB RTX Spark 上的推理速度超过 220 tk/s,并在 SWE-Bench Pro v2、Terminal-Bench 2.1 和 SWE-bench verified 等智能体编程基准测试中取得同类领先的成绩。
Recursive Flint 使用 Recursive 的 Eureka Machine 构建,该系统专为大规模自动化 AI 研究而设计。它可自动完成整个研究循环:提出想法、实现想法、运行实验验证想法,再根据结果决定下一步尝试方向。系统创建了专用计算内核,在不改变模型权重的情况下,将 Flint 在 RTX Spark 上的生成速度提升了 55%。
开发者可在 Hugging Face 下载以 Apache 2.0 许可开放的模型权重,并在 RTX Spark、DGX Spark,以及 GeForce RTX 和 RTX PRO GPU 上运行该模型。
查看 Recursive Superintelligence 的发布博客,了解更多详情。
首日支持全新模型
NVIDIA 将从发布首日起支持 NVIDIA Nemotron Bolt E4B 4B、GLM、DeepSeek、Qwen、MiniMax,以及 FLUX.3 Klein 扩散模型。
Nemotron Bolt E4B 4GB 仅需 4GB 内存,即可实现自然对话和多轮智能体任务能力,为 NVIDIA GeForce RTX GPU、NVIDIA Jetson 设备,以及 RTX Spark 和 DGX Spark 上的快速本地语音助手、交互式游戏角色和嵌入式界面提供支持。Bolt E4B 4GB 将于 10 月 23 日发布。
Black Forest Labs 的 FLUX 3 Image Klein 是一个拥有 56 亿参数的开放权重图像模型,可用于图像生成和编辑。NVIDIA 优化的版本仅需 8GB 显存即可在 GeForce RTX GPU 上运行。
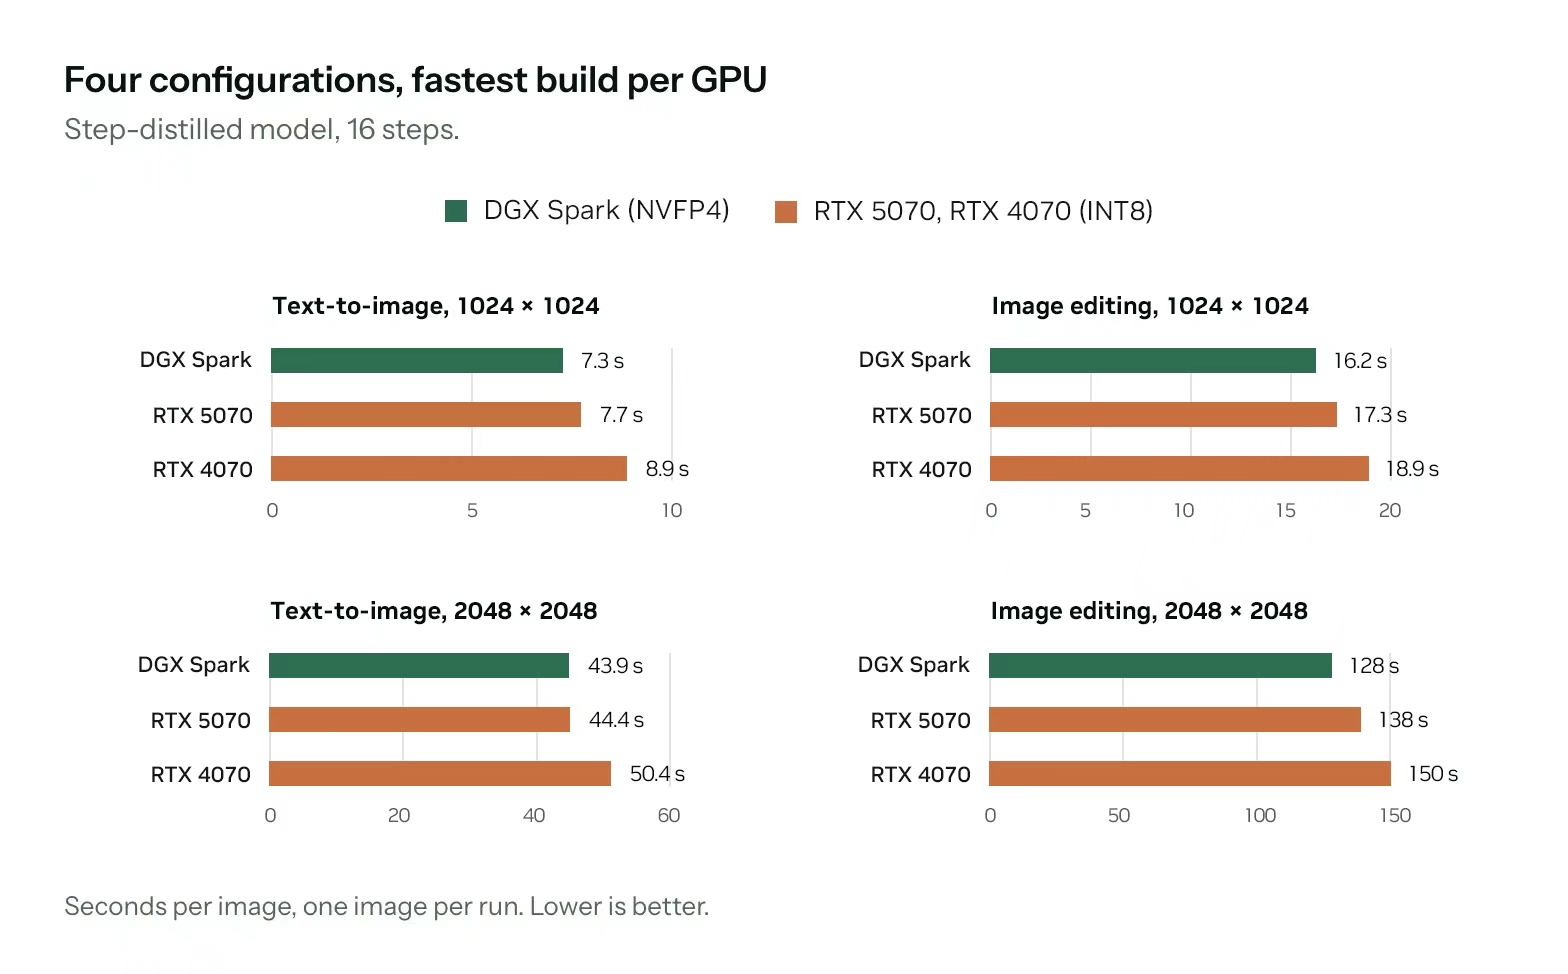
MiniMax M3.1 Flash 是一款专为 DGX Spark 打造的全新开放模型,将长上下文 AI 带到桌面。Liquid AI 的 LFM2.5-24B-A2B 是一款开放权重推理模型,每处理一个 Token,仅激活其 240 亿参数中的 20 亿参数,从而实现快速运行,让用户可直接在 PC 上运行注重隐私、支持工具调用的 AI 智能体。
此外,NVIDIA 发布了一组全新的模型 checkpoints,针对本地 AI 硬件的内存使用效率进行优化, 让前沿级开放模型运行时,仍能为 KV 缓存留出充足内存。每个 checkpoint 都经过量化,同时保持接近全精度的准确性。首批包括可在单台 DGX Spark 128GB 上运行的 Qwen3.8-Flash-Next-FP4-Local,以及可在两台 DGX Spark 上运行的 GLM-5.3-Flash-FP4-Local。
加速 AI 推理
NVIDIA 持续与 llama.cpp 和 vLLM 等开源社区合作,加速本地硬件上的智能体工作负载。
在 llama.cpp 中,面向 Qwen 3.8 Flash Next、基于多 Token 预测 (MTP) 的全新推测解码支持,可将 NVIDIA RTX PRO Blackwell 上的端到端智能体任务执行速度最高提升至 1.4 倍。
在 vLLM 中,更快的推测解码,以及面向 Qwen 线性注意力层的全新 FlashInfer 预填充内核,可将 DGX Spark 上 Qwen3.8 27B 智能体任务的执行速度至高提升 1.3 倍。
NVIDIA RTX AI PC 的相关信息请关注微博、抖音及哔哩哔哩官方账号,并订阅 NVIDIA 本地 AI 新闻,及时了解最新动态。软件产品信息请查看声明。
请根据您所在区域适用的法律要求浏览、选择和使用资源。